Читать полный материал
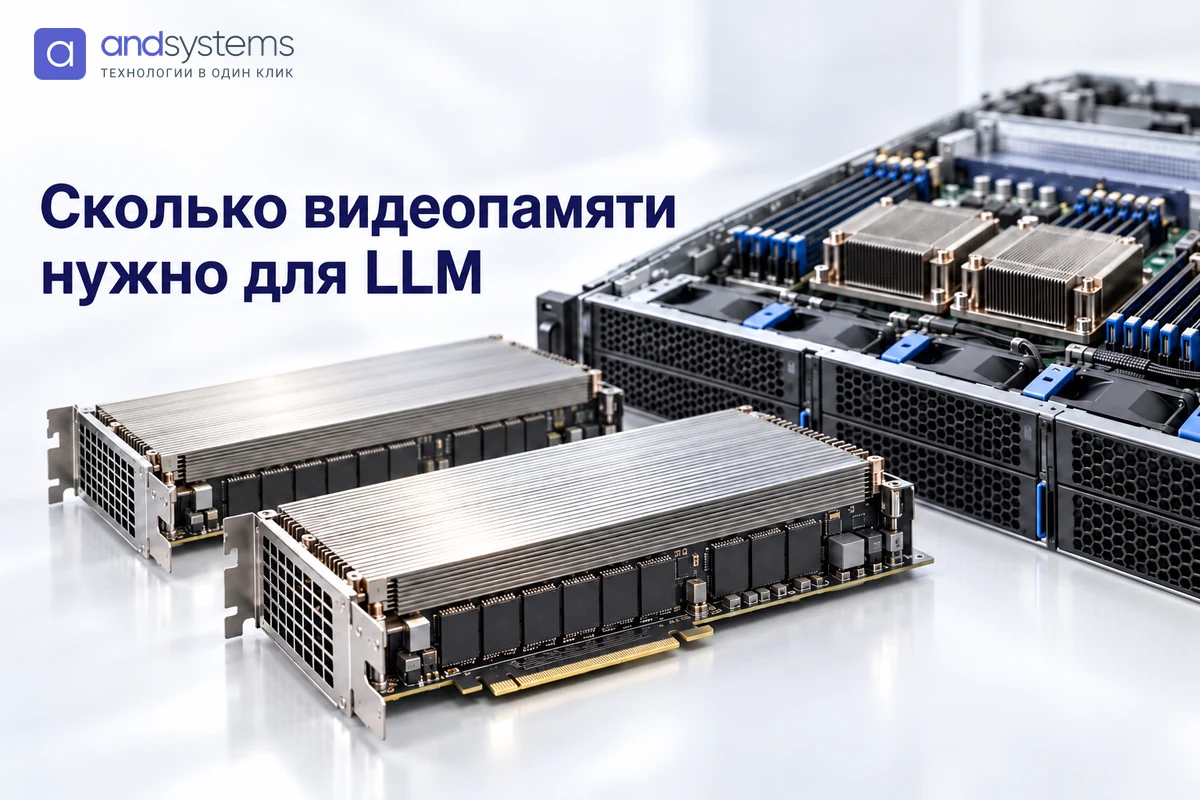
Самый частый вопрос при покупке GPU-сервера под нейросеть — «хватит ли памяти». Ответ считается заранее: модели нужно место под веса, под KV-кэш каждого активного диалога и под рабочую среду. Если что-то не поместится, модель не запустится или будет обслуживать меньше пользователей, чем планировали.
Ниже — простая методика расчёта, пример для модели на 70 миллиардов параметров и разбор того, от чего зависит скорость ответа в токенах в секунду.
Что разобрано в статье
Веса модели
Сколько занимают параметры при FP16, FP8 и 4 битах.
KV-кэш
Память под контекст каждого пользователя.
Пример 70B
Расчёт для 15 одновременных сессий.
Скорость
Почему токены в секунду упираются в пропускную способность памяти.
Из чего складывается видеопамять
При инференсе — работе уже обученной модели — память GPU уходит на три вещи:
- Веса модели — параметры, загружаемые один раз при старте.
- KV-кэш — промежуточные данные для каждого токена контекста каждого активного диалога. Растёт с длиной контекста и числом пользователей.
- Рабочая среда — активации, буферы библиотек, фрагментация памяти. Серверы инференса обычно резервируют под себя заданную долю памяти.
Считать нужно все три части. Ошибка «модель 40 ГБ — значит, хватит карты на 48 ГБ» — типичная: на KV-кэш для нескольких пользователей места уже не остаётся.
Веса: параметры × байты на параметр
Объём весов приблизительно равен числу параметров, умноженному на размер одного параметра:
| Формат весов | Байт на параметр | Модель 8B | Модель 70B |
|---|---|---|---|
| FP16 / BF16 | 2 | ≈ 16 ГБ | ≈ 140 ГБ |
| FP8 | 1 | ≈ 8 ГБ | ≈ 70 ГБ |
| 4 бита (INT4, FP4) | ≈ 0,5 + служебные данные | 4 ГБ + служебные данные | 35 ГБ + служебные данные |
Квантизация уменьшает размер весов; фактический объём включает масштабы и метаданные формата. Скорость и качество зависят от модели, оборудования и программных ядер — их измеряют на своей задаче. Здесь ГБ — 10⁹ байт, ГиБ — 2³⁰ байт: 140 ГБ составляют примерно 130,4 ГиБ.
Для полностью размещённой на GPU MoE-модели бюджет весов считают по всем параметрам, а не только активным экспертам. Выгрузка части весов в RAM — отдельный режим с иными задержками; число активных параметров само по себе не задаёт скорость.
KV-кэш: контекст × пользователи
На каждый токен контекста модель хранит ключи и значения для каждого слоя. Объём на один токен:
2 × число слоёв × число KV-голов × размер головы × байт на элемент
Для иллюстративной архитектуры с 80 слоями, 8 KV-головами и размером головы 128 при FP16 получается 327 680 байт, или 0,3125 МиБ на токен. Это расчёт, а не измерение конкретной модели:
- один диалог с контекстом 8 000 токенов — около 2,62 ГБ (2,44 ГиБ);
- 15 одновременных диалогов по 8 000 токенов — около 39,3 ГБ (36,6 ГиБ);
- KV-кэш в FP8 вдвое меньше — около 19,7 ГБ без накладных расходов на те же 15 диалогов.
Точные параметры архитектуры берите из файла конфигурации конкретной модели: у разных моделей число слоёв и голов отличается, и KV-кэш может различаться в разы.
Пример: модель 70B на 15 пользователей
| Статья расхода | Объём |
|---|---|
| Веса, 4 бита | ≈ 40 ГБ |
| KV-кэш, 15 × 8 000 токенов, FP16 | ≈ 39,3 ГБ |
| Рабочая среда и запас 15–20% | ≈ 12–16 ГБ |
| Итого | ≈ 91–95 ГБ |
Веса 40 ГБ и запас 12–16 ГБ здесь — условия примера, а не паспорт конкретного формата модели. Расчёт не гарантирует запуск на карте 96 ГБ: часть памяти резервирует runtime, CUDA graphs и другие буферы. Число GPU выбирают после замера памяти и задержек на целевом программном стеке, а не по этой сумме в одиночку.
Что определяет скорость ответа
При декодировании одного потока ограничением часто становится пропускная способность видеопамяти. Деление доступной полосы на объём читаемых весов даёт лишь грубую оценку: влияют ядра, формат, KV-кэш и архитектура. Обработка входного запроса (prefill) может сильнее зависеть от вычислений.
Пакетирование позволяет обслуживать запросы совместно, но рост суммарного числа токенов в секунду не означает пропорционального роста скорости каждого пользователя. Проверяют отдельно пропускную способность, задержку первого токена и задержки следующих токенов при целевом контексте.
При тензорном параллелизме важен обмен между GPU: фактические линии PCIe, топология, доступность NVLink и поддержка выбранного сервера инференса. PCIe 5.0 x16 не является универсальным обязательным условием для любой модели.
Требования к серверу под несколько GPU
- Слоты и топология — проверьте число линий, габариты, межсоединение и совместимость карт с платформой.
- Питание — считайте по точным моделям: например, RTX PRO 6000 Blackwell Workstation Edition имеет заявленные 96 ГБ памяти и мощность до 600 Вт. Это не характеристика всех профессиональных GPU.
- Охлаждение — активные и пассивные карты требуют разного воздушного потока и корпуса.
- RAM сервера — рассчитывайте по загрузчику, числу моделей и CPU-offload; правила «не меньше суммы VRAM» для всех систем нет.
- Накопители — объём считают по сохранённым версиям и форматам моделей, скорость — по требуемому времени загрузки.
Первоисточники
- vLLM — уменьшение расхода памяти
- Hugging Face Transformers — KV-кэш
- NVIDIA — RTX PRO 6000 Blackwell Workstation Edition
Сверено 17 октября 2026 года. Точные режимы и ограничения проверяйте для своей модели оборудования и версии ПО.
Частые вопросы
Можно ли запустить модель, если VRAM не хватает?
CPU-offload позволяет вынести часть данных в RAM, если это поддерживает выбранный runtime. Влияние на скорость измеряют: оно зависит от объёма обмена и платформы; заранее фиксированного коэффициента замедления нет.
Что важнее: больше памяти на карту или больше карт?
Для одной крупной модели удобнее меньше карт с большим объёмом: меньше обмена между ними. Для нескольких независимых моделей или сервисов — больше карт.
Подойдут ли игровые видеокарты?
Проверяйте доступную память, охлаждение, совместимость драйверов, условия поддержки и реальные задержки под нагрузкой. Само название класса GPU не гарантирует пригодность для круглосуточного сервиса.
Поможете рассчитать конфигурацию под нашу модель?
Да. Пришлите модель, длину контекста, число одновременных пользователей и желаемую скорость ответа на info@andpro.ru — подберём GPU и платформу с расчётом.
Авторство и ответственность
Материал подготовлен для блога ANDPRO / ООО «АНД-Системс» как информационная статья о расчёте видеопамяти для инференса языковых моделей. Приведённые значения — оценки для типичных архитектур; точный расчёт делается по параметрам конкретной модели и программного стека.
Для подбора оборудования под вашу задачу обратитесь в ANDPRO: info@andpro.ru, +7 (495) 545-48-70, +7 (800) 707-78-15.
Дата последнего обновления материала: 18 октября 2026 года.