Читать полный материал
По руководству Intel по оптимизации программ, скорость процессоров росла быстрее скорости доступа к памяти. Кэш помогает сократить число обращений к оперативной памяти; для оставшихся обращений важно учитывать задержку и пропускную способность.
В статье — структура трёх уровней кэша, разница между приватным кэшем ядра и общим LLC, цифры для конкретных Intel Xeon Scalable и AMD EPYC 9004, политика хранения копий данных, когерентность в многосокетных серверах и область применения AMD 3D V-Cache. Материал входит в раздел блога о процессорах.
Что разобрано в статье
Три уровня кэша
Официальная роль L1, L2 и L3/LLC по документации Intel и AMD.
Реальные цифры
Официальные размеры кэша для конкретных линеек Intel Xeon Scalable и AMD EPYC 9004.
Когерентность
Почему многосокетным серверам нужен протокол когерентности кэша.
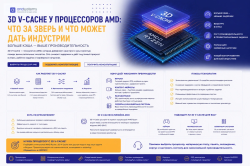
AMD 3D V-Cache
AMD заявляет: EPYC 7373X выполняет RTL-симуляцию в Synopsys VCS до 66% быстрее, чем EPYC 73F3.
Зачем процессору кэш: разрыв между скоростью CPU и памяти
Руководство Intel по оптимизации программ связывает важность кэша с разрывом между скоростью процессора и скоростью доступа к оперативной памяти. Практических подхода два: чаще обслуживать обращения к данным из кэша либо организовать вычисления так, чтобы задержка оставшихся обращений к памяти меньше мешала работе и использовалась доступная пропускная способность.
Руководство AMD по архитектуре процессора описывает кэш как ближайшие к вычислительным блокам уровни памяти: они меньше оперативной памяти, но доступ к ним быстрее. В кэше хранятся копии часто используемых инструкций и данных. Насколько это помогает конкретной программе, зависит от её обращений к памяти, а не только от паспортного объёма кэша.
Три уровня: L1, L2, L3 — роль каждого
В документации Intel описаны три уровня: L1 включает кэш данных, L2 хранит инструкции и данные и относится к отдельному ядру, а L3 служит общим кэшем для ядер в пределах процессора. Такая иерархия помогает скрывать задержку доступа к внешней памяти; конкретная организация зависит от поколения и модели.
Руководство AMD уточняет: кэш данных L1 удерживает недавно прочитанные или записанные данные, а кэш инструкций L1 — часто исполняемые инструкции. L2 обычно вместительнее L1, но медленнее; в нём могут оставаться недавно использованные данные и инструкции, не поместившиеся в L1. Это объясняет компромисс между объёмом и задержкой разных уровней.
Приватный кэш ядра против общего LLC
Для микроархитектуры Skylake Server Intel указывает приватный для каждого ядра L2 объёмом 1 МБ и минимальную задержку от загрузки данных до их использования в 14 тактов. L3, или кэш последнего уровня, описан как общий для ядер процессора. Эти цифры относятся именно к названной микроархитектуре.
Для линейки EPYC 9004 AMD указывает до 1 МБ приватного L2 на ядро; до восьми ядер Zen 4 могут разделять L3 внутри одного комплекса ядер. Поэтому при оценке общей нагрузки важно учитывать не только объём L3 на процессор, но и то, какие ядра разделяют конкретный участок кэша.
Реальные цифры: Intel Xeon Scalable и AMD EPYC
Справка Intel 000027820 приводит для Xeon Scalable 4-го поколения 2 МБ кэша среднего уровня и 1,875 МБ кэша последнего уровня на ядро; для 5-го поколения — соответственно 2 и 5 МБ на ядро. Страница Intel ARK для Xeon Platinum 8592+ (64 ядра) указывает суммарный объём кэша 320 МБ, но не обозначает это поле явно как L3; не следует превращать подпись ARK в более точное утверждение, чем даёт источник.
В спецификации AMD EPYC 9004 для модели EPYC 9654 (96 ядер) указано 384 МБ L3, а для EPYC 9684X (96 ядер, технология 3D V-Cache) — 1152 МБ L3. Руководство AMD по настройке высокопроизводительных вычислений приводит до 32 КБ кэша инструкций L1 и до 32 КБ кэша данных L1 на ядро, а также до 1 МБ приватного L2. Эти цифры относятся к указанным моделям и линейке, а не ко всем серверным процессорам.
Inclusive и non-inclusive дизайн LLC
В руководстве AMD инклюзивность означает, что кэш верхнего уровня содержит копию данных из нижнего уровня; при эксклюзивной организации такое дублирование не требуется. Документ объясняет принцип на отношении L1 и L2. Для отношения L2 и L3 конкретную политику необходимо проверять по архитектуре процессора, а не выводить из общего определения.
Intel описывает кэш последнего уровня Skylake Server как общий, распределённый и неинклюзивный: блок данных, находящийся в L2 одного ядра, может не иметь копии в L3. Для более ранних Xeon E5 v4 Intel указывала общий инклюзивный L3 объёмом 2,5 МБ на ядро; при переходе к первым Xeon Scalable — неинклюзивный L3 объёмом 1,375 МБ на ядро. Так сравнивается конкретная смена архитектуры, а не все поколения Xeon без исключения.
Когерентность кэша в многосокетных серверах
В многоядерной системе разные ядра могут хранить копии одних и тех же данных. Руководство AMD описывает протокол когерентности MOESI и его состояния: изменённая, принадлежащая одному участнику, эксклюзивная, разделяемая и недействительная копия. При промахе чтения или записи система проверяет, не находится ли актуальная версия данных в другом кэше. Это важно и в многосокетной системе, где доступ к данным проходит через межпроцессорные связи.
Для платформ AMD EPYC документация указывает, что кристалл ввода-вывода участвует в поддержании когерентности и соединяет фабрику данных со вторым процессором через межсокетный интерфейс xGMI. Это связано с топологией NUMA: путь доступа к удалённой памяти и межсокетные обмены нужно учитывать при размещении потоков и данных. Сама по себе удалённость копии в кэше не даёт универсальной численной оценки задержки.
AMD 3D V-Cache: когда большой L3 даёт реальный прирост
Технология AMD 3D V-Cache увеличивает объём L3 за счёт вертикального размещения дополнительных кристаллов кэша. В руководстве AMD по настройке EPYC 9004 описаны до 96 МБ L3 на кристалл для соответствующей конфигурации. Спецификация этой серии приводит конкретные модели с большим L3: EPYC 9684X — 1152 МБ, EPYC 9384X — 768 МБ. Эти значения не следует переносить на обычные модели серии.
В пресс-релизе AMD для EPYC 3-го поколения заявлено: в RTL-симуляции Synopsys VCS процессор EPYC 7373X выполнял тест до 66% быстрее, чем EPYC 73F3. Это результат внутреннего теста AMD для конкретной пары моделей и нагрузки. Вычислительная гидродинамика, анализ методом конечных элементов и расчёт конструкций названы отдельно как целевые задачи; показатель 66% к ним не относится. Подтверждённой вендором цифры прироста для баз данных или плотности виртуальных машин в собранных источниках нет.
Частые вопросы
Почему нельзя просто сделать один большой и быстрый кэш вместо трёх уровней?
Потому что скорость и объём кэша — это компромисс: чем больше физический массив памяти, тем выше задержка обращения к нему. По документации AMD, L1 — самый маленький и быстрый, L2 обычно вместительнее и медленнее L1, а L3 — ещё больше и медленнее L2, но быстрее оперативной памяти. Три уровня помогают совместить скорость и объём.
В чём разница между L2 и L3 (LLC) с точки зрения совместного использования?
По официальной документации Intel и AMD, L1 и L2 приватны для каждого ядра — другие ядра не имеют к ним прямого доступа. L3 (last-level cache, LLC) — общий ресурс, разделяемый всеми ядрами процессора (или комплекса ядер, как CCX у AMD), поэтому при высокой многопоточной нагрузке ядра реально конкурируют за место в L3.
Что означает «non-inclusive» кэш и зачем это нужно?
По документации Intel, в кэше без обязательного включения содержимого L2 в LLC данные одного ядра не обязательно дублируются в L3. Это отличается от устройства более старого Xeon E5 v4, где L3 содержал копии данных L2. Разница важна при оценке эффективной ёмкости кэша; сама по себе она не доказывает преимущество процессора в конкретной нагрузке.
Зачем серверу протокол когерентности кэша?
Потому что несколько ядер (и несколько процессоров в многосокетном сервере) хранят собственные копии одних и тех же данных в приватных кэшах. По официальной документации AMD, протокол MOESI следит за тем, чтобы при изменении данных в одном кэше остальные копии признавались недействительными или получали актуальную версию при следующем обращении — иначе разные ядра могли бы работать с устаревшими данными.
Что такое AMD 3D V-Cache и для каких задач он полезен?
Это технология AMD, при которой дополнительный кристалл L3-кэша размещается поверх основного, увеличивая суммарный объём LLC — до 1152 МБ у модели EPYC 9684X. В пресс-релизе AMD показатель до 66% относится к RTL-симуляции Synopsys VCS на EPYC 7373X относительно EPYC 73F3. Для вычислительной гидродинамики и анализа методом конечных элементов AMD приводит отдельные результаты с другими моделями и метриками; переносить на них показатель 66% нельзя.
Поможете подобрать процессор и сервер с учётом объёма кэша под нашу задачу?
Да. Пришлите описание нагрузки (тип задачи, объём рабочего набора данных, число потоков) на info@andpro.ru или через форму на /services/ — подберём процессор и конфигурацию сервера с учётом реальных требований к кэшу.
Авторство и ответственность
Материал подготовлен для блога ANDPRO / ООО «АНД-Системс» как информационная статья об архитектуре кэша серверных процессоров. Статья не заменяет индивидуальный подбор конфигурации сервера под конкретную задачу заказчика.
Материал подготовлен при участии AI-ассистента, прошёл фактчекинг и редакторскую вычитку. Формулировки проверены против официальной документации Intel и AMD — см. sources.md.
Для подбора конфигурации сервера под вашу задачу обратитесь в ANDPRO: info@andpro.ru, +7 (495) 545-48-70, +7 (800) 707-78-15.
Разборы серверного железа — в Telegram-канале ANDPRO.